瑞士 Apertus 1.5 发布:8B/70B 模型新增图像音频理解与思考模式,上下文扩至 262k
Apertus 1.5 Release Notes
Project Apertus 发布 Apertus 1.5,在 8B 和 70B 两档上新增图像/音频理解、可选思考模式,上下文窗口扩至 262,144 tokens(4 倍),权重以 Apache 2.0 在 Hugging Face 开放。
我们的最新版本 Apertus 1.5 扩展了 8B 和 70B Apertus 1.0 模型,增加了图像/音频理解能力、可选的思考模式、四倍长的上下文窗口、改进的指令跟随和更好的工具使用。更新的 8B 和 70B 模型权重 于 2026 年 7 月 24 日在 Hugging Face 上发布,采用 Apache 2.0 许可证。更多细节现在可以在项目 技术报告 中找到,并在此处总结。
Apertus 1.5 是第一代模型的持续预训练:向 8B 模型添加 40 万亿个文本和多模态训练数据,向 70B 模型添加 20 万亿个文本,分别达到 190 万亿和 170 万亿。与每个 Apertus 发布一样,模型是完全开放的:开放 权重、开放 数据、开放 值,以及完整的训练 细节。
关键增强功能
- 原生多模态理解:Apertus 1.5 接受图像和音频,与文本一起使用,将文档、图表和照片带入对话。模型还可以处理口语,但这仍然是实验性的。
- 思考模式:模型可以切换到思考模式,在回答之前对输入进行推理,从而提高推理问题的性能。
- 长上下文:上下文窗口扩展到 262,144 个标记,比 Apertus 1.0 增加了四倍。
- 改进的指令跟随:比 Apertus 1.0 更好的指令遵循,提供更可预测和准确的响应。
- 改进的工具使用:模型经过训练以更好地集成工具,允许更有效地使用外部工具和 API。
- 开放值:更强地遵循 Apertus 宪章,这为模型的价值和原则带来了透明度。
训练过程
 完整的 Apertus 1.5 训练流程
通过分词器实现多模态
我们在 v1.5 模型中以一种早期融合的方式引入了多模态,其中图像和音频作为独立的标记与文本标记一起进入 Apertus,而不是使用单独的视觉编码器。图像使用 Emu3.5 分词器进行分词(512×512 的图像变为 1,024 个标记),音频使用 WavTokenizer(每秒 40 个标记)。我们只扩展词汇表,因此架构保持不变,训练以纯文本速度运行。模型理解图像和音频,但只生成文本。

预训练
从 Apertus 1.0 开始,我们继续分四个阶段进行预训练:
- 无配对:文本加上独立的图像和音频,以便模型学习新的模态。
- 配对:图像-标题和音频-转录对,以便将其与语言对齐。
- 冷却:更高质量的数据,包含更多数学和代码。
- 长上下文:窗口逐步从 8k 增长到 262k 个标记。
总的来说,超过一半的训练标记是纯文本的,这保留了 Apertus 1.0 的语言能力。文本数据通过 FineWeb2-HQ+、FinePDFs 和 Nemotron-CC 等来源进行更新。所有新数据,包括多模态,都符合之前的标准:公开可用、许可,并尊重 robots.txt 的事后排除。每个来源都在 apertus-data-transparency 中列出。
后训练
训练后运行分为五个阶段:SFT → 长上下文 SFT → RL → DPO → 宪章对齐 (SDPO)。
- SFT 在 3.7M 文本样本以及图像和语音数据上进行。推理轨迹仅添加到模型在没有它们的情况下无法解决的提示中。工具使用数据仅限于经过执行验证的轨迹。我们在 Hugging Face 上发布了我们使用的 文本 SFT 混合集。
- 长上下文 SFT 在完整的 262k 窗口中恢复了短上下文 SFT 损耗的长上下文能力。
- 带可验证奖励的强化学习 (RLVR) 在大约 350k 数学、代码、指令跟随、多语言和视觉提示上进行,混合在线和离线思考。
- DPO 使用裁判评分的偏好对提高了聊天质量、工具使用和安全。我们发布了 偏好池 和 训练对。
- SDPO 通过裁判反馈和自我蒸馏使模型与 Apertus 宪章 保持一致。
评估结果
除了扩展的模型能力外,我们还显著扩展了评估范围。除了用于 Apertus 1.0 的现有基于文本的评估外,我们还添加了多模态评估(图像 & 音频)和思考模式评估。
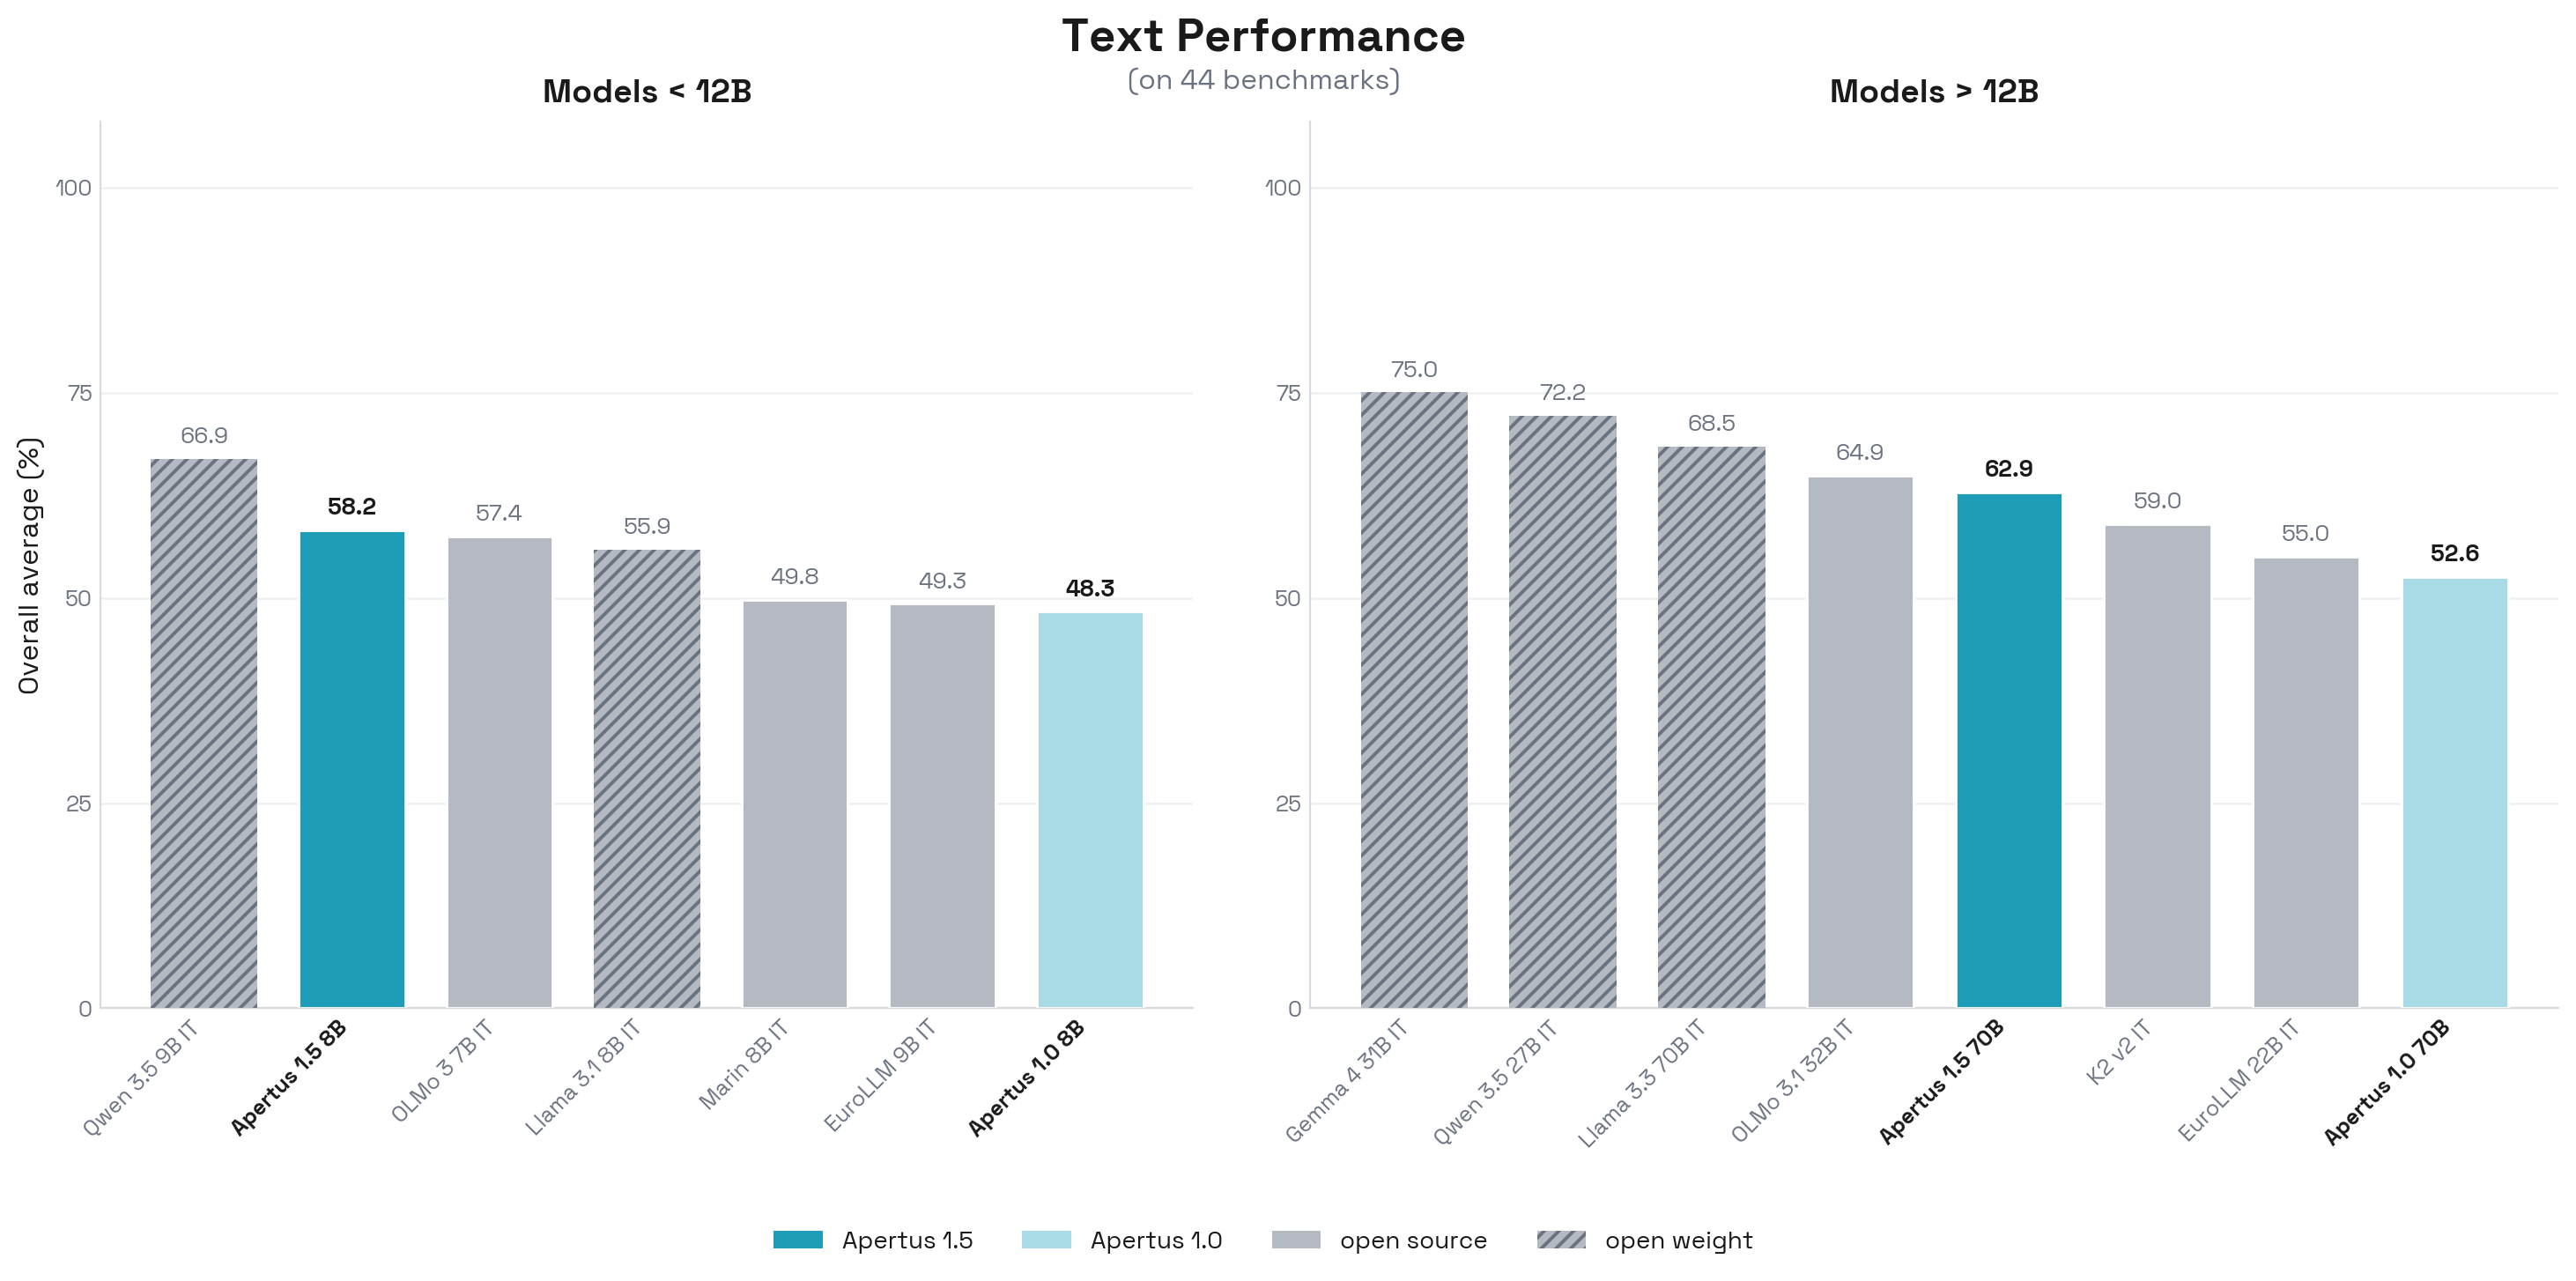
多模态评估通过 MLLM-eval-suite 管道进行,合并了两个主要的 多模态评估框架 lmms-eval 和 VLMEvalKit。我们还添加了一系列基于文本的基准测试,以及翻译和多语言能力的扩展基准测试、安全性和工具使用的基准测试。这些可以在我们的训练后 评估存储库 中找到,基于 lm-evaluation-harness 分叉。
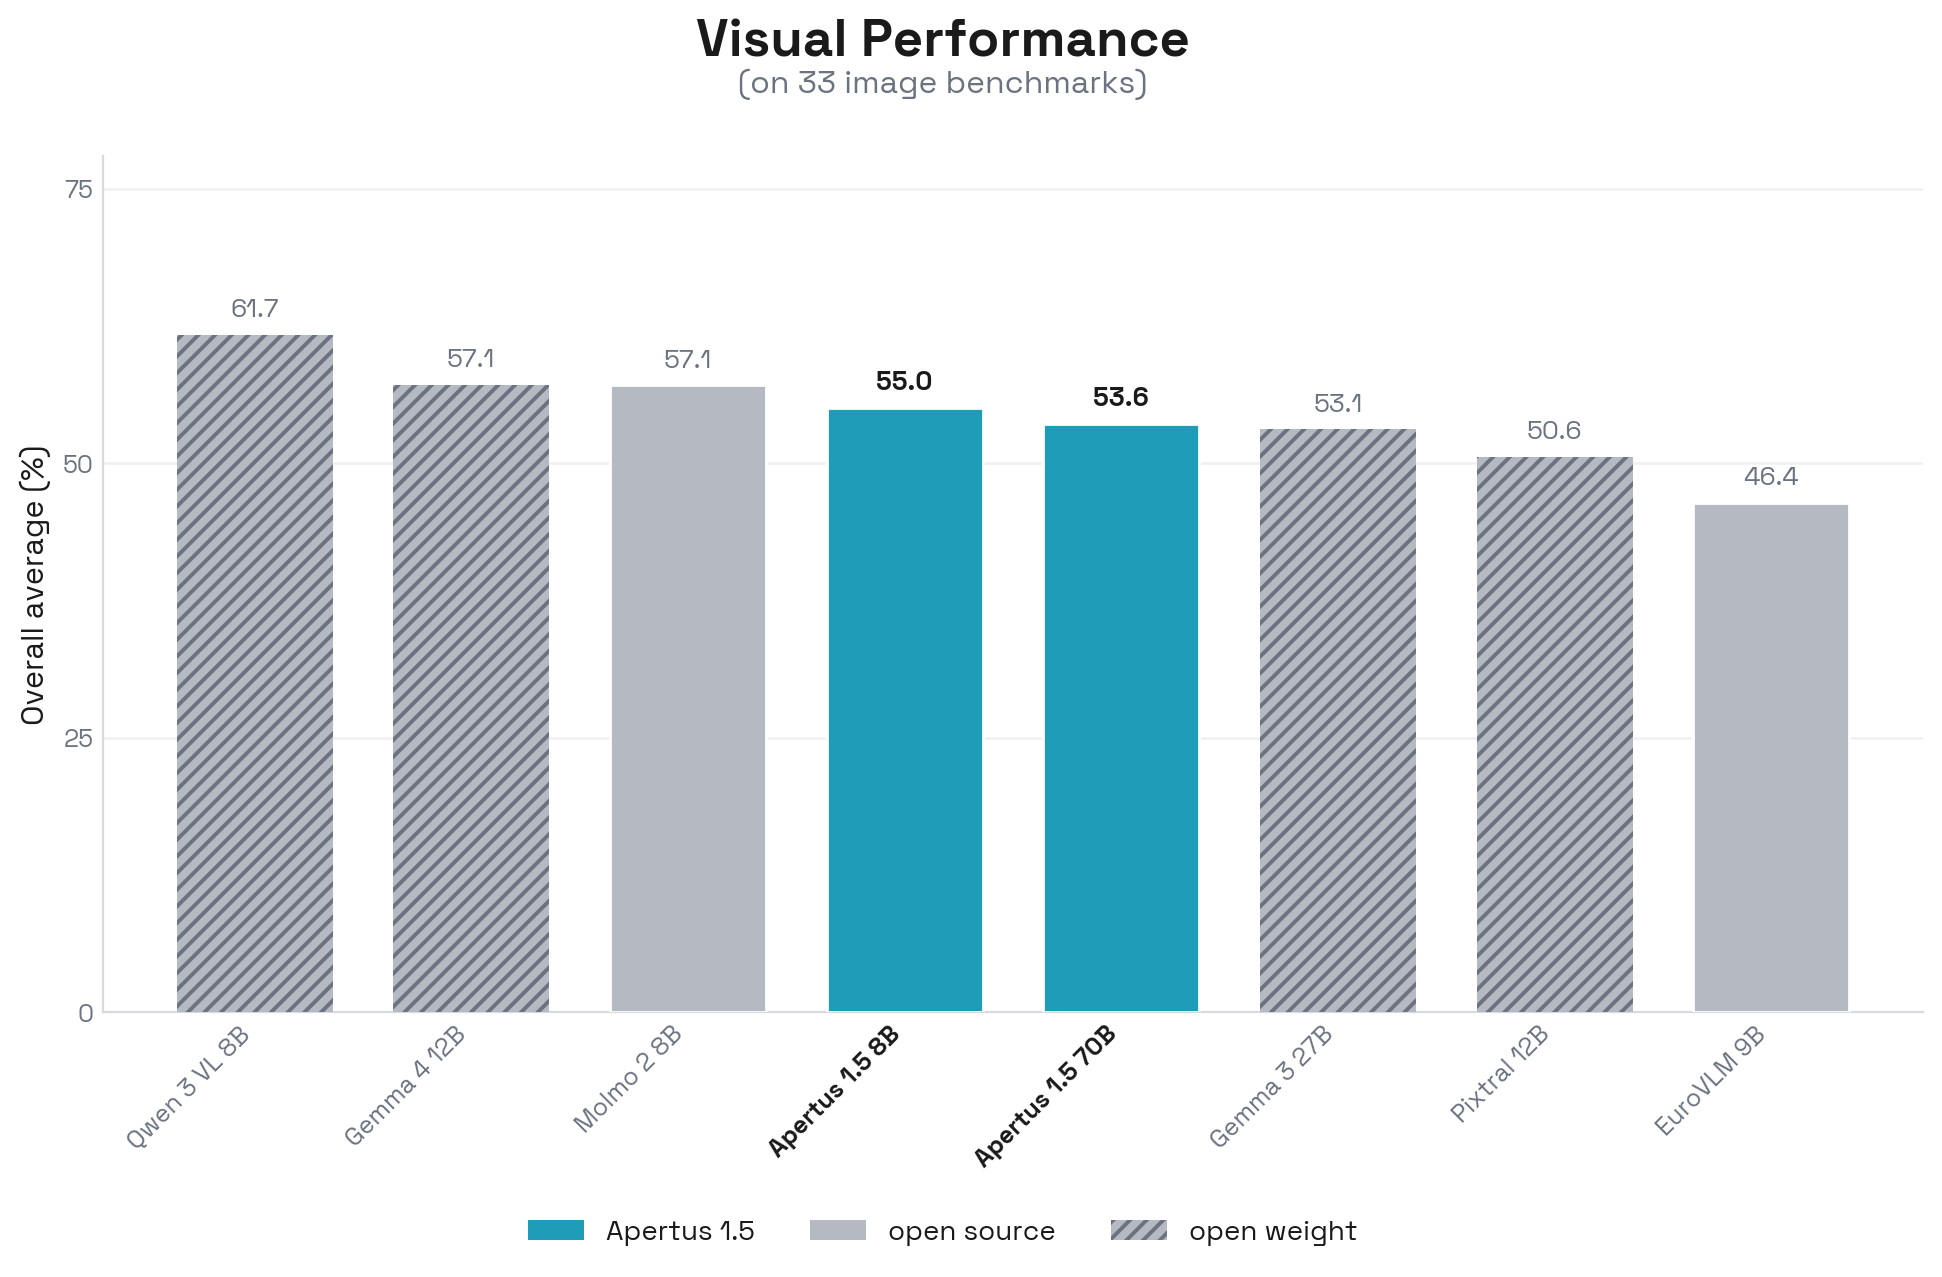
虽然仍然落后于前沿的开权重量模型,但新版本在编码和指令跟随能力方面也有了显著改进,Apertus 1.5 8B 在 IF 和多语言任务上优于同等规模的开权重量模型。在 AIME 等具有挑战性的推理密集型基准测试中,思考进一步提高了性能。该模型的多模态性能接近 Gemma 4 12B 和其他当前的开权重量模型。在开权重量模型中,Apertus 1.5 的多模态性能在空间理解方面具有竞争力,在开源模型中,文档/图表理解方面也具有竞争力。
我们也感谢我们的合作者和外部评估者帮助我们高效地评估Apertus的能力。特别是,Apertus 1.5在瑞士法律任务上表现出色,与领先的开权重模型相当(博客, 代码)。此外,在最新翻译基准测试中,Apertus 1.5 8B展示了与GPT-OSS-20B相当且优于Claude Haiku 4.5或谷歌翻译的机器翻译能力(排行榜, 论文)。
评估卡片:Apertus ❤️ EvalEval
Apertus 与 EvalEval 联盟 合作,以确保完全透明和可复现的基准测试。我们在 Every Eval Ever (EEE) 格式中发布 Apertus 1.5 的结果,这是一种共享格式,不仅记录分数,还记录了谁运行了评估、如何访问模型、生成设置以及每个指标应如何解释:这些通常是排行榜中缺失的详细信息,并且常常解释了为什么看起来相似的分数会有所不同。
结果显示在下方的 Eval Card 中,它将运行数据与基准测试和模型元数据结合到一个可解释的记录中,并且也通过 Hugging Face Community Evals 提供。这是 英国人工智能安全研究所 用于公开发布其评估的基础设施。由于我们的文本评估运行在我们的公共分支 lm-evaluation-harness 上,而 EEE 通过专用转换器支持它,因此任何人都可以重新运行它们,并在相同设置下将他们的分数与我们的分数进行比较。
结构化的评估报告在研究之外也很重要。EvalEval 已将 Eval Cards 映射到人工智能治理要求,包括欧盟人工智能法案的第 55 条和 GPAI 实践守则,并发现 EEE 格式可以表示这些框架要求的 60 个评估报告元素中的 56 个。这符合我们发布 Apertus 的方式:除了模型之外,我们发布一个 公共摘要 的训练内容,并且自愿地发布一个 实践守则 文档。可机器读取的评估记录是下一步:使监管机构、部署者和研究人员更容易找到、解释和比较模型背后的证据。
我们致力于通过 Eval Cards 和 EEE 格式促进可复现和透明的评估,并鼓励其他模型开发人员以同样的方式报告他们的结果,以便可以在模型和组织之间比较分数。
Apertus 1.5 可复现性
所有配方、消融实验和数据混合都在 技术报告 中进行了记录。我们旨在通过公开和可访问的 v1.5 训练过程来推广开源模型开发。中间检查点托管在我们的 Apertus 1.5 Hugging Face 收藏 中,包括基础权重、SFT、RLVR 和 DPO,以及我们在 Apertus 1.5 数据集收藏 中的策划训练数据混合/自定义数据集。共享它们允许研究人员调查每个阶段如何改变模型行为。
报告涵盖了不同阶段对后训练数据影响的多个消融实验,我们在其中观察到,在 SFT 期间与文本数据混合的多模态数据有助于提高所有模态。我们还发现,多模态推理跟踪的好处在随后的纯文本强化学习中仍然存在:从使用多模态跟踪训练的 SFT 检查点开始,RL 比从纯文本检查点开始时更能提高数学能力,并且在推理任务上的优势贯穿整个训练过程。
| 模型 | 8B | 70B |
|---|---|---|
| 预训练(长上下文基础) | Apertus-v1.5-8B-base | Apertus-v1.5-70B-base |
| 监督微调 (SFT) | Apertus-v1.5-8B-SFT | Apertus-v1.5-70B-SFT |
| 强化学习 (RLVR) | Apertus-v1.5-8B-RL | Apertus-v1.5-70B-RL |
| 偏好对齐 (DPO) | Apertus-v1.5-8B-DPO | Apertus-v1.5-70B (final) |
| Charter alignment (SDPO) | Apertus-v1.5-8B (final) | – |
| Stage | Data | Code / recipe |
|---|---|---|
| Pre-training: Stages 1–2 (unpaired, paired) | All sources with versions and licenses in apertus-data-transparency; vision and audio processing recipes in multimodal-data | Megatron-LM, launch scripts in pretrain-code, apertus-omni-tokenizer, benchmark-image-tokenizer, benchmark-audio-tokenizer (incl. interleaved speech–text builder) |
| Pre-training: Stage 3 (cooldown) | apertus-data-transparency; curated image datasets NASA, Our World in Data, Smithsonian, swisstopo | Megatron-LM, launch scripts in pretrain-code |
| Long-context extension | apertus-data-transparency; synthetic long-context tasks in LongContextQA | Megatron-LM, launch scripts in pretrain-code |
| SFT | Apertus-v1.5-SFT-mix (multimodal SFT mix listed in the report) | posttraining-data, Megatron-LM (SFT launch scripts) |
| Long-context SFT | Subsets of the SFT mix (listed in the report), plus LongContextQA tasks | Megatron-LM |
| RL (RLVR) | Mixture listed in the report | verl, verl-recipe |
| DPO | Apertus-v1.5-Preference-Pool (annotated completions), Apertus-v1.5-Preference-Data (pairs) | posttraining, verl |
| SDPO (charter alignment, 8B only) | gretelai/gretel-safety-alignment-en-v1 | self-distillation |
Model Availability
Proton Lumo and Infomaniak Euria are two widely used apps that have recently integrated Apertus 1.5. These deployments are linked in the Community Showcase among others - see this discussion thread for a preview.
Access to Apertus 1.5 in the form of an API for developers has been announced by a range of providers, including Swisscom, Infomaniak, Phoeniqs, and other companies listed in our General Availability guide. The report also provides details on how we work with external evaluators to test and prepare the models.
Technical instructions for running the models are in the model cards of the Apertus releases on Hugging Face and in our Quickstart guide.
How to Get Involved
Thank you for reading this blog post and being part of our community! We just celebrated five million downloads in our Hugging Face analytics 🤗 and are not slowing down. At the recent AI+X Summit in Zurich, our team announced the roadmap for Apertus 2.0: sparse/MoE architecture, ~600B total parameters, extended training schedule, with agents, mathematics and coding as priorities.
总的来说:我们邀请您阅读我们的报告,下载模型,探索中间检查点,微调权重,并复现我们的评估。欢迎提出在我们的出版物或网站常见问题解答中尚未涵盖的问题,我们也非常乐意听取社区对未来深入探讨最有用的主题的建议。
如果您使用Apertus进行开发或使用,请填写展示表单,并通过联系我们页面上的选项与我们联系。我们期待着展示更多工作成果,了解您正在构建的内容,并听取如何改进Apertus的建议!
引用
Apertus项目等. “Apertus 1.5: 从开放文本模型到开放多模态推理器.” arXiv:2610.15542. 预印本, arXiv, 2026年10月11日. https://doi.org/10.48550/arXiv.2610.15542.
@misc{apertus2026apertus15opentext,
      title={Apertus 1.5: From Open Text Models to Open Multimodal Reasoners},
      author={Project Apertus and Yixuan Xu and Yassine Turki and Vinko Sabolčec and Valentina Pyatkin and Tommy Chu and Sven Najem-Meyer and Sean F. Carroll and Robert Smith and Raphael Kreft and Oscar Alessandro Tazza and Oleg Lavrovsky and Nicola Irmiger and Matteo Santelmo and Marian Schneider and Juan García Giraldo and Hanna Yukhymenko and Eduard Ďurech and Davit Melikidze and Dani Tamayo and Bettina Messmer and Aryan Ahadinia and Anunay Yadav and Allen Huang and Ahmad Fraij and Alessandro Bombarda and Alex Padula and Alexander Hägele and Alexander Sternfeld and Anna Hedström and Anna Kosovskaia and Arthur Wuhrmann and Arundhati Balasubramaniam and Badr Al Mahouri and Barna Pasztor and Bartosz Szostakiewicz and Bich Ngoc Doan and Bryan Schmid and Burak Sezen and Camille Challier and Clément Charmillot and Dana Shayakhmetova and Daniel Perruchoud and David Brüggemann and David Isztl and Elia Palme and Emma Anastassova and Fabian Bösch and Faruk Zahiragić and Fawzi Roberto Mohamed and Fiona Panicali and Florian Kolly and Flynn Guerra and Francesco Monti and Frederike Lübeck and Gennaro Oliva and Haofeng Yang and Haoliang Shang and Helen El Khoury and Henrique Mendonça and Jannis Vamvas and Jérome Landolt and Jessica Lam and Jingchun Xiao and Jonathan Coles and Joshua Oyebanji and Khanh Nguyen and Konstantinos Pitas and Lasse B. Strand and Li Mi and Loïc Deslarzes and Lorenzo Baggi and Lorenzo Noci and Luca Baumann and Luca Sartori and Lukas Drescher and Marco De Negri and Marco Passerini and Mark Klein and Marko Stojanovic and Martin Majsec and Matin Ansaripour and Mattea Busato and Mauro Pellonara and Max Neuwinger and Michael Graber and Michal Tešnar and Michelle Wastl and Miguel Gila and Mikolaj Boronski and Morgane Magnin and Moritz Reihs and Mukhammadali Sayfiddinov and Nathan Ranchin and Nicolas Cuveillier and Oscar Wohlfahrt and Qianqian Zou and Rada Kamysheva and Rita Sevastjanova and Roman Machacek and Sebastian Keller and Simon Matrenok and Simon Pierre and Stefano Schuppli and Suei-Wen Chen and Szabina Horváth-Mikulas and Taliesin Perez and Thilo Spinner and Thomas Kleine Buening and Tim Robinson and Tymoteusz Kwiecinski and Vilém Zouhar and Vinzenz Thoma and Xiaozhe Yao and Yannick Metz and Yuhei Fukuhara and Yusif Askari and Zixuan Chen and Alexander Ilic and Ana Klimovic and Andreas Krause and Andrei Kucharavy and Elliott Ash and Joost VandeVondele and Martin Rajman and Mennatallah El-Assady and Thomas Schulthess and Timo Kehrer and Torsten Hoefler and Antoine Bosselut and Martin Jaggi and Imanol Schlag},
      year={2026},
      eprint={2610.15542},
      archivePrefix={arXiv},
      primaryClass={cs.CL},
      url={https://arxiv.org/abs/2610.15542},
}
来源:Hugging Face Blog · huggingface.co