在 Amazon Bedrock AgentCore Runtime Instances 上构建多智能体音乐制作流水线
Build a multi-agent music production pipeline on Amazon Bedrock AgentCore Runtime Instances
AWS 官方博客演示在 Amazon Bedrock AgentCore Runtime Instances 上部署三智能体音乐制作流水线:作曲、交付、合规三个智能体通过同一 runtimeSessionId 共享一个 GPU 实例和文件系统,作曲智能体在 NVIDIA L4 上用 ACE-Step 模型约 9 秒渲染 20 秒 48 kHz 立体声。
随着组织从单一用途的智能体转向多智能体系统,基础设施需求也随之改变。一个处理客户查询的独立智能体可以在无服务器环境中运行,会话短暂。但当你需要三个智能体协作完成一个跨越数天的创意工作流,共享上下文并相互基于彼此的输出进行构建时,上限只有几小时的无服务器会话就不够用了。
在本文中,我们将逐步演示如何部署一个音乐制作流水线:一个智能体在实例自有的 GPU 上运行生成式音频模型。另外两个智能体从共享卷中打开它写入的 .wav 文件。到最后,你将得到一首可以播放的曲目。你还将学会如何创建容量提供程序、从不同构件类型部署智能体、使用共享会话编排智能体之间的协作,以及让工作流跨越多天持久运行。
Amazon Bedrock AgentCore 提供两种用于托管智能体的计算选项。MicroVM 是无服务器选项:冷启动快、会话隔离、按用量计费。Runtime Instances 是新选项:由 AWS 托管的 EC2 基础设施,用于持久、长时间运行的智能体工作流。两者使用相同的运行时 API,但 Instances 增加了多天会话、GPU、持久卷,以及将多个智能体共置于单个实例上的能力。
Runtime Instances 与 MicroVM 的区别
两种选项都支持自定义框架(CrewAI、LangGraph、LlamaIndex、Strands Agents),可与您选择的基础模型配合使用,与 MCP 和 A2A 集成,并共享相同的 AgentCore 运行时 API。区别在于底层计算模型。
| 能力 | MicroVM(无服务器) | Runtime Instances |
| 计算 | 完全由 AWS 托管 | AWS 托管的 EC2 实例 |
| 会话时长 | 最长 8 小时 | 最长 14 天 |
| 每计算单元的智能体数 | 一个运行时(microVM)托管一个智能体(1:1) | 一个实例(EC2)可托管多个智能体(1:N) |
| 构件类型 | 容器镜像和 Amazon S3 源 | 容器镜像和 Amazon S3 源 |
| GPU 访问 | 不支持 | 支持,在受支持的实例系列上 |
| 会话持久性 | 会话范围 | 持久存储(Amazon EBS) |
| 定价 | 按用量计费 | EC2 实例在您的账户中运行。使用您的 AWS Savings Plans 和 On-Demand Capacity Reservations(ODCR) |
| 扩缩容 | 按需扩展 | 由容量提供程序管理 |
智能体是在会话中运行的工作负载。与一个运行时托管一个智能体的 MicroVM 模型不同,单个 Instances 会话可以托管多个智能体。当两个智能体运行时共享同一个容量提供程序时,您可以使用相同的 runtimeSessionId 调用它们,使两个智能体落在同一个 EC2 实例上。在那里,它们共享文件系统,并可以协作完成同一任务。
解决方案概述
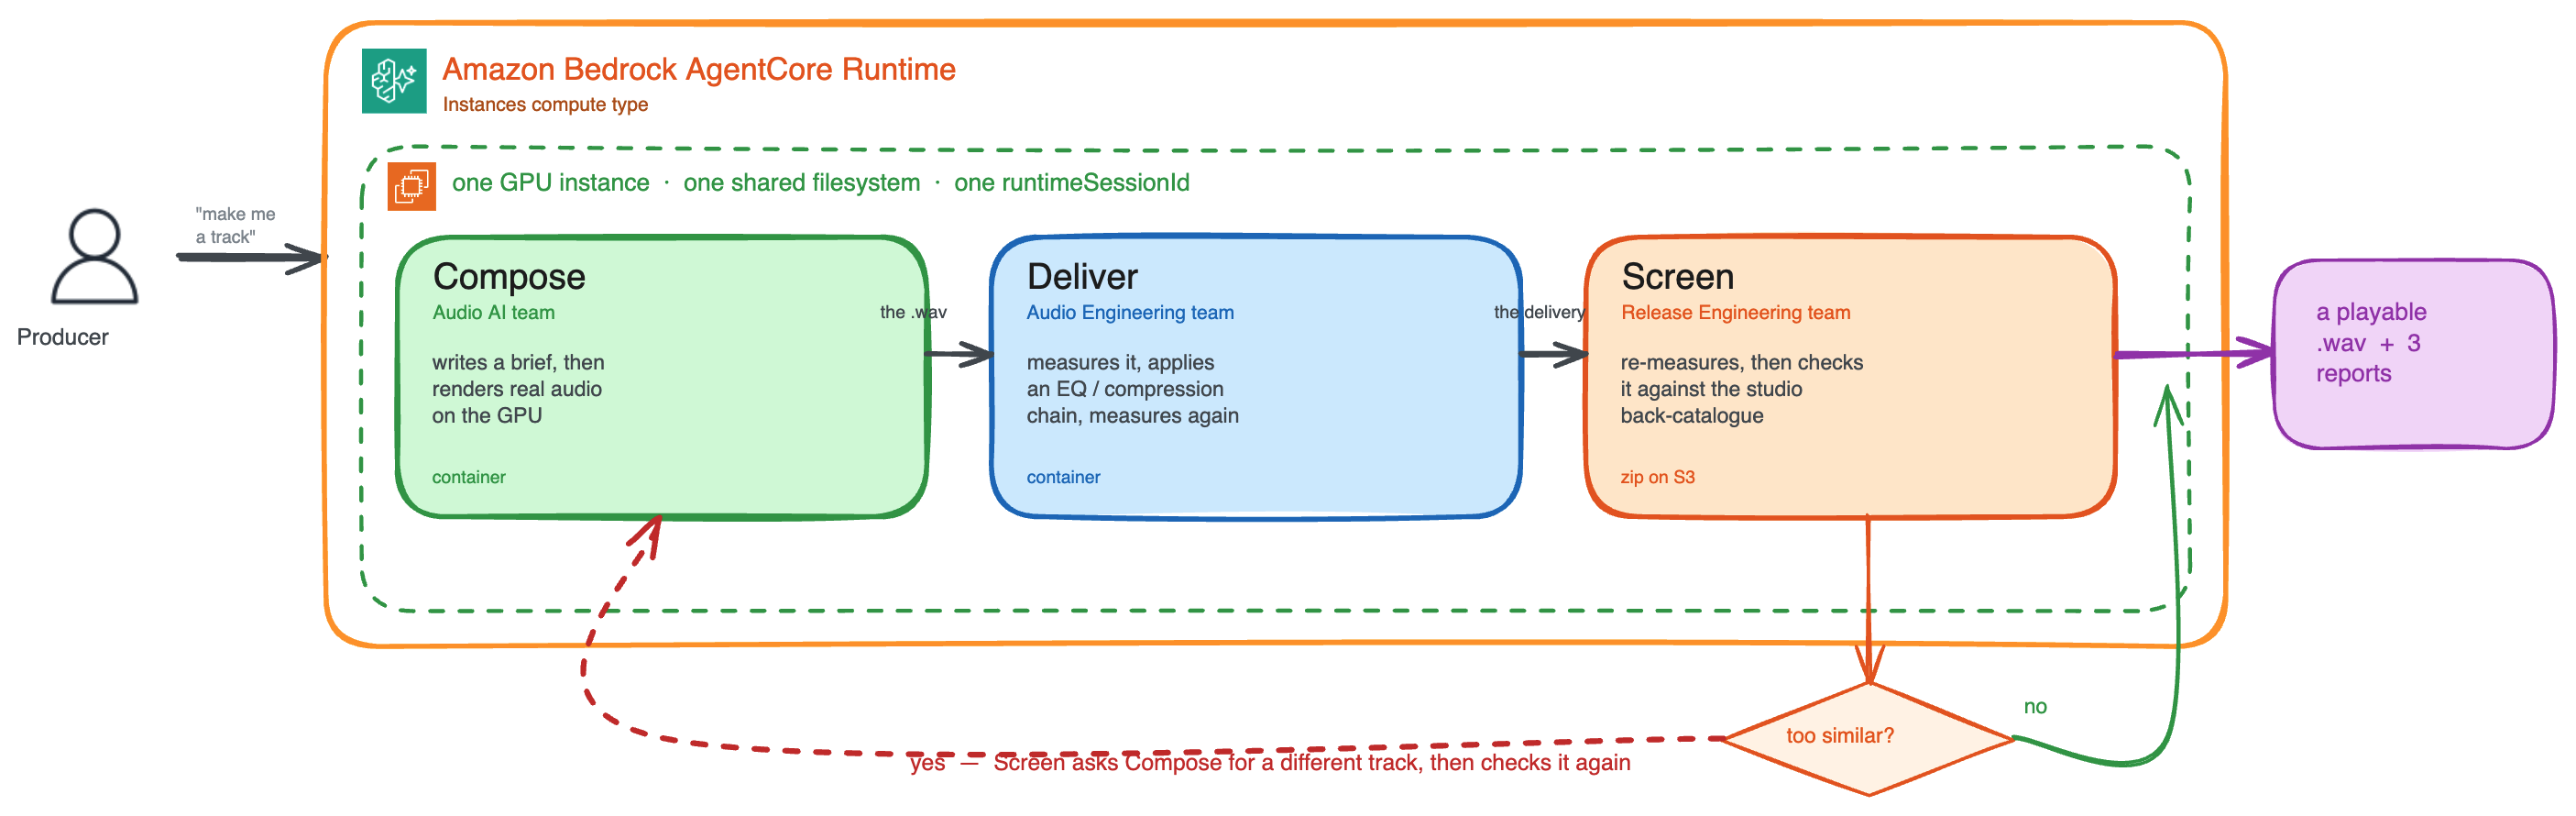
图 1:三个智能体流水线(Compose、Deliver、Screen)共享一个 GPU 实例和会话
我们将构建一个使用三个专用智能体的音乐制作系统:
- 作曲智能体(Audio AI 团队):使用 Claude Sonnet 4.6 将制作人的请求转化为音乐简报,然后使用生成式音乐模型(ACE-Step,一个用于音乐生成的开源基础模型(FM))在实例自有的 GPU 上渲染实际音频。打包为 Amazon Elastic Container Registry(Amazon ECR)中的容器镜像。
- 交付代理(音频工程团队):从共享文件系统读取渲染后的音轨并进行测量,然后基于这些测量结果而非音频本身,向 Claude Sonnet 4.6 请求一条交付链(EQ、压缩、限制)。真实的信号处理会应用到该链上,随后再次测量结果以确认其达到了交付目标。打包为 Amazon ECR 中的容器镜像。
- 合规代理(发布工程团队):独立地重新测量已完成的交付,对照交付代理所声称的交付目标进行检查,并筛查其与工作室自有曲库的谐波相似度。如果筛查提出异议,该代理会回调作曲代理以获取替代品并重新筛查。以 zip 文件形式交付到 Amazon Simple Storage Service(Amazon S3)上。
工作流程:制作人启动一条音轨。作曲代理撰写一份简报,并在实例的 GPU 上渲染真实音频。交付代理打开该文件,对其进行测量,应用一条由这些测量结果推导出的处理链,然后再次测量以证明结果达到了目标。随后合规代理独立地重新测量,检查交付目标,并对照工作室的曲库筛查音频。如果筛查标记出匹配,它会回调作曲代理以生成替代方案。制作人最终得到一个可播放的 .wav 文件和三份解释每项决策的报告。
在 Runtime Instances 上实现这一点的关键:
- 通过共享会话 ID 实现同置。每个代理都有自己的运行时,但通过在同一容量提供者上使用相同的
runtimeSessionId调用它们,AgentCore 会将它们放置在同一实例上,并挂载相同的卷。它们共享一个文件系统,可以访问彼此的输出。 - 可用的 GPU。作曲代理直接在实例的 NVIDIA L4 上运行 ACE-Step 基础模型,约 9 秒即可渲染 20 秒的 48 kHz 立体声。模型及其依赖项存放在持久卷上。每个会话构建一次,然后该会话中的每次调用都复用它,包括隔夜停止之后。
- 独立部署。每个团队按自己的节奏发布自己的制品。音频 AI 团队推送新的作曲镜像,无需与音频工程或发布工程团队协调,而另外两个团队继续不受影响地运行。
- 多日持久性。制作人在周一进行作曲,隔夜停止会话,周二恢复交付。实例会自动闲置,并在下次调用时恢复。
- 混合制品。来自 ECR 的容器和来自 S3 的代码包共存于同一个容量提供者上。团队选择适合自己工作流程的打包方式。
演练
从这里开始,本文进入实操环节。你将准备好自己的 AWS 账户,然后运行一个三智能体流水线,它会渲染、生成并清理一条完成的音轨,最终产出一个可播放的 .wav 文件。请按顺序逐步操作。你首先要确认先决条件,然后定义三个智能体(第 1 步),创建一个容量提供程序来预置 GPU 实例及其持久卷(第 2 步),将每个智能体部署为独立的运行时(第 3 步),并使用共享的会话 ID 调用它们,使它们能够共置在一个实例上并相互交接工作(第 4 步)。最后,第 5 步展示了任何一个团队如何在不干扰其他团队的情况下发布其智能体的新版本。完整示例位于 AgentCore samples GitHub 仓库中。
先决条件
在开始之前,请确保你具备:
- 一个 AWS 账户,以及一个能够创建基础设施的主体的凭证。此示例会创建 AWS Identity and Access Management (IAM) 角色、一个 S3 存储桶、ECR 仓库,以及一个 AgentCore 容量提供程序和运行时。
- 已安装并配置好 AWS Command Line Interface (AWS CLI)。
- 一个虚拟私有云 (VPC),其中至少有一个子网和安全组。
- 已在 Amazon Bedrock 控制台中为 Anthropic Claude Sonnet 4.6 启用模型访问权限。
- 已在本地安装 Finch 或其他兼容 OCI 的容器工具。
- 已安装 Python 3.10+。
- boto3 ≥ 1.36.0 或 botocore ≥ 1.43.72。较旧版本缺少
create_capacity_provider,deploy.py将会失败。
如需完整可运行的代码,请参阅 GitHub 上的 AgentCore samples 仓库。
第 1 步:定义你的智能体
AgentCore Runtime Instances 支持任何智能体框架。在此示例中,每个智能体都是一个使用 Strands Agents 构建的 Python 应用程序。
有两个细节经常被错误配置,而且两者都会以令人困惑的方式失败:
@app.entrypoint
def invoke(payload, context):  # the parameter must be NAMED "context"
    session_id = getattr(context, "session_id", None) or "local-session"
SDK 根据参数名称进行分发(它会检查 params[1] == "context")。这是读取会话 ID 的唯一方式,智能体需要该 ID 来查找彼此的文件并相互调用。
其次,在处理器内部构建 Agent,而不是在模块作用域中:
def build_agent(session_id: str, track_id: str) -> Agent:
    return Agent(
        name=AGENT_NAME,
        model=BedrockModel(model_id=MODEL_ID, region_name=REGION),
        system_prompt=SYSTEM_PROMPT,
        session_manager=FileSessionManager(
            session_id=f"{session_id}-{AGENT_NAME}",
            storage_dir=str(track_path(track_id) / f".sessions-{AGENT_NAME}"),
        ),
    )
模块级的 Agent 会在并发请求之间共享,而 Strands 会以 Agent is already processing a request 拒绝可重入调用。历史记录通过 FileSessionManager 保存在卷上,这就是几天后恢复的会话仍能记住先前决策的原因。
作曲智能体
作曲智能体使用 Claude Sonnet 4.6 将制作人请求(提示词)转化为音乐简报,然后使用 ACE-Step 基础模型渲染实际音频:
@app.entrypoint
def invoke(payload, context):
    session_id = getattr(context, "session_id", None) or "local-session"
    track_id = payload.get("track_id", "demo-track")
    if payload.get("mode") == "prepare":
        return {"status": "ok", "model_stack": prepare_model_stack()}
    ensure_track_dir(track_id)
    brief = build_agent(session_id, track_id)(
        payload["prompt"], structured_output_model=CompositionBrief
    ).structured_output
    wav = track_path(track_id) / "composition.wav"
    render = render_audio(wav, brief, duration_s=payload.get("duration_s", 30.0))
    write_text(track_id, "composition.md", brief.to_markdown(render))
    return {"status": "ok", "render": render, "host": host_info(),
            "artifacts": [publish(track_id, wav)]}
mode=prepare 调用会将整个技术栈构建到卷上,即一个包含 CUDA PyTorch 和 ACE-Step 的 virtualenv。渲染在该卷的解释器下作为子进程运行:
proc = subprocess.run(
    [status["python"], status["runner"], "--out", str(out_path),
     "--prompt", brief.style_tags, "--duration", str(duration_s)],
    capture_output=True, text=True, check=False,
    timeout=RENDER_TIMEOUT_S, env=gpu_env(),
)
交付智能体
交付智能体从共享文件系统读取渲染后的音轨并对其进行测量。它使用 Claude Sonnet 4.6 来选择 EQ 频段、压缩器设置以及哪些内容保持不动。随后应用数字信号处理 (DSP)。然后再次测量输出,因此计划是被验证的,而不是被信任的。
before = audio.measure(str(source))  # ITU-R BS.1770-4
plan = build_agent(session_id, track_id)(
    f"Prepare this for {platform} delivery.\n{json.dumps(before.to_dict())}",
    structured_output_model=DeliveryPlan,
).structured_output
data, rate = audio.read_audio(str(source))
bands = [b.model_dump() for b in plan.eq_bands]
if bands:
    data = audio.apply_filters(data, rate, bands)
if plan.compressor.enabled:
    data, _ = audio.compress(
        data, rate,
        threshold_db=plan.compressor.threshold_db,
        ratio=plan.compressor.ratio,
        attack_ms=plan.compressor.attack_ms,
        release_ms=plan.compressor.release_ms,
        knee_db=plan.compressor.knee_db,
    )
data, _ = audio.normalise_loudness(data, rate, plan.target_lufs)
data, _ = audio.limit(data, rate, ceiling_dbtp=plan.target_true_peak_dbtp)
audio.write_audio(str(delivery), data, rate, subtype="PCM_24")
after = audio.measure(str(delivery))  # verify, don't trust
合规智能体
合规智能体独立地重新测量完成的交付内容,对照交付智能体声称的交付目标进行检查,并筛查其与工作室自有过往作品库的谐波相似度。当发现相似之处时,它会发出标记并回调作曲智能体进行修复。
client = boto3.client(
    "bedrock-agentcore", region_name=REGION,
    config=Config(read_timeout=600, retries={"max_attempts": 3, "mode": "standard"}),
)
response = client.invoke_agent_runtime(
    agentRuntimeArn=COMPOSITION_RUNTIME_ARN,  # injected at deploy time, not hard-coded
    qualifier=COMPOSITION_QUALIFIER,
    runtimeSessionId=session_id,  # the caller's own --- routes to this instance
    payload=json.dumps({
        "mode": "remediate", "track_id": track_id,
        "issue": issue,
        "avoid": avoid or {},
    }).encode(),
)
body = json.loads(response["response"].read())  # "response", not "body"
第 2 步:创建容量提供程序
容量提供程序会告诉 AgentCore 为你的代理预置哪些计算基础设施。你指定实例类型和 VPC 放置位置。AgentCore 负责预置和生命周期管理。
你需要两个 IAM 角色,而且这个区别很重要:
- 一个操作员角色,AgentCore 代入该角色来代表你预置 EC2:启动、标记和终止实例及其网络接口。附加托管策略
BedrockAgentCoreRuntimeInstancesOperatorRolePolicy。 - 一个执行角色,你的代理进程在运行时代入该角色来调用 Bedrock 和 S3。
CreateAgentRuntime需要它,没有它就会失败。
两者都信任 bedrock-agentcore.amazonaws.com。
现在创建容量提供程序。注意名称必须使用下划线(不允许使用连字符):
control = boto3.client("bedrock-agentcore-control", region_name=REGION)
resp = control.create_capacity_provider(
name="music_production_capacity",
permissionsConfiguration={"capacityProviderOperatorRoleArn": operator_arn},
computeConfiguration={
"ec2Configuration": {
"launchTemplateSource": {
"launchParameters": {
"operatingSystem": "LINUX_X86_64", "instanceRequirements": {"allowedInstanceTypes": ["g6.xlarge"]},
}
},
"vpcConfiguration": {"subnets": subnets, "securityGroups": groups},
"volumes": [
{"ebsConfiguration": {"name": "tracks", "sizeGiB": 20,
"volumeType": "gp3", "encrypted": True}},
{"ebsConfiguration": {"name": "models", "sizeGiB": 60,
"volumeType": "gp3", "encrypted": True,
"throughput": 500}},
],
"rootVolume": {"freeSpaceGiB": 30, "volumeType": "gp3"},
"lifecycleConfiguration": {"idleInstanceTimeout": 600,
"maxLifetime": 86400},
}
},
) GPU 容量。 如果你在多个可用区(AZ)中尝试分配 GPU 实例时遇到
InsufficientInstanceCapacity,可以切换到另一种 GPU 实例类型,例如 g5.xlarge。相应地更新 allowedInstanceTypes。
步骤 3:部署代理运行时
这里的每个代理都有自己的运行时。这些运行时在调用时被汇集在一起。当两个运行时共享一个容量提供程序,并且你用相同的 runtimeSessionId 调用它们时,AgentCore 会将两个代理放在同一个 EC2 实例上,它们在那里共享文件系统,并可以在同一任务上协作。这就是交付代理读取合成代理写入的 .wav 文件的方式。
接下来,将每个运行时指向容量提供程序,并声明它挂载哪些卷:
composition = control.create_agent_runtime(
    agentRuntimeName="music_production_composition",
    roleArn=execution_arn,  # required
    agentRuntimeArtifact={"containerConfiguration": {"containerUri": image_uri}},
    protocolConfiguration={"serverProtocol": "HTTP"},
    capacityProviderConfiguration={"capacityProviderArn": cp_arn},
    filesystemConfigurations=[
        {"capacityProviderVolume": {"volumeName": "tracks", "mountPath": "/mnt/tracks"}},
        {"capacityProviderVolume": {"volumeName": "models", "mountPath": "/mnt/models"}},
    ],
    lifecycleConfiguration={"idleRuntimeSessionTimeout": 600, "maxLifetime": 86400},
    environmentVariables={"AWS_REGION": REGION, "WORKSPACE_DIR": "/mnt/tracks",
        "MODELS_DIR": "/mnt/models", "MODEL_ID": MODEL_ID},
)
合规代理的调用相同,只是工件不同,是 zip 而不是镜像,并且只挂载工作区卷:
agentRuntimeArtifact={"codeConfiguration": {
    "code": {"s3": {"bucket": bucket, "prefix": key}},
    "runtime": "PYTHON_3_12",
    "entryPoint": ["compliance_agent.py"],
}},
步骤 4:使用共享会话编排多代理工作流
现在调用这些代理。这就是三个代理变成一条流水线的地方:你向每次调用传递相同的 runtimeSessionId。第一次调用比较慢,因为它要预置实例。之后的每次调用都会路由到已经运行的实例。
client = boto3.client(
    "bedrock-agentcore", region_name=REGION,
    config=Config(read_timeout=900, retries={"max_attempts": 2, "mode": "standard"}),
)
session_id = f"music-production-{uuid.uuid4()}"  # 33-100 characters

def invoke_agent(runtime_arn, payload):
    response = client.invoke_agent_runtime(
        agentRuntimeArn=runtime_arn, qualifier="DEFAULT",
        runtimeSessionId=session_id, payload=json.dumps(payload).encode(),
    )
    return json.loads(response["response"].read())

invoke_agent(COMPOSITION_ARN, {"mode": "prepare"})
invoke_agent(COMPOSITION_ARN, {"mode": "catalogue", "track_id": track_id, "duration_s": 20})
invoke_agent(COMPOSITION_ARN, {"mode": "compose", "track_id": track_id, "duration_s": 30,
    "prompt": "Create an upbeat electronic track with heavy bass and synth melodies."})
invoke_agent(DELIVERY_ARN, {"track_id": track_id, "platform": "spotify",
    "prompt": "Prepare this for streaming delivery."})
result = invoke_agent(COMPLIANCE_ARN, {"track_id": track_id,
    "prompt": "Screen this delivery for release."})
print(result["outcome"])  # cleared | review_required | not_cleared
这是在 us-east-2 中一个实时 g6.xlarge 上产生的结果:
1. prepare model stack (GPU instance + torch + weights)  239s
   host : ip-172-31-11-83.us-east-2.compute.internal
   stack : ready=True in 125s
2. render back-catalogue  66s
3. compose (renders audio on the GPU)  25s
   rendered : NVIDIA L4 in 8.98s (peak VRAM 7.63 GiB)
   audio 20.062s 48000Hz 2ch -7.5 LUFS peak 0.42 dBTP
4. delivery (real DSP, verified by measurement)  41s
   read : composition.wav <- written by another agent
   before -7.5 LUFS peak 0.42 dBTP
   after -14.0 LUFS peak -3.2 dBTP
   targets : loudness met, true peak held
5. compliance screen  28s
   verdict : REVIEW REQUIRED
   screen : 2 reference(s), closest catalogue_00.wav distance 0.0665 (review)

-- collocation --  All 5 steps were served by one instance, as intended.
当你调用 StopRuntimeSession 时,实例会自动空闲下来。空闲期间不会产生计算费用。当你再次调用该会话时,AgentCore 会恢复它,前提是它落在同一个可用区。Amazon Elastic Block Store(Amazon EBS)卷是锁定可用区的。如果原可用区容量枯竭,卷无法重新挂载,持久性就会丢失。使用固定可用区的 ODCR 或 MODELS_SNAPSHOT_ID,这样重新放置后的恢复才能成功。会话最多可以持续 14 天。
步骤 5:独立更新代理
这种架构的优势之一是独立部署。当音频 AI 团队发布合成代理的新版本时,他们只更新自己的运行时:
# Audio AI team pushes new container version
finch build --platform linux/amd64 \
  -f Dockerfile.composition \
  -t "$ECR/music-production/composition-agent:v2" .
finch push "$ECR/music-production/composition-agent:v2"
control.update_agent_runtime(
agentRuntimeId=composition_id, # all three are required
roleArn=execution_arn,
agentRuntimeArtifact={"containerConfiguration": {"containerUri": new_uri}},
capacityProviderConfiguration={"capacityProviderArn": cp_arn},
)交付代理和合规代理继续保持不变地运行。无需协调,没有共享部署流水线,也没有因你的更新而破坏另一个团队代理的风险。
清理
先删除会话。这是停止 EC2 和 Amazon EBS 费用最直接的方法。删除会话会取消预置 EC2 资源:实例、网络接口和 Amazon EBS 卷。删除容量提供程序也会停止并删除其关联的会话及其持久存储。但是,你必须先解除每个运行时和运行时版本与它的关联,而且这种解除是异步的。删除会话是快速路径,也是你想避免持续费用时应该采用的方法。
data = boto3.client("bedrock-agentcore", region_name=REGION)
data.delete_capacity_provider_session(capacityProviderId=cp_id, sessionId=session_id)
for rid in runtime_ids:
    control.delete_agent_runtime(agentRuntimeId=rid)
# Versions detach from the capacity provider asynchronously, so poll here.
control.delete_capacity_provider(capacityProviderId=cp_id)
然后删除 ECR 仓库、S3 工件、IAM 角色和 Amazon CloudWatch 日志组。
结论
在这篇文章中,我们在 Amazon Bedrock AgentCore Runtime Instances 上部署了一个多智能体音乐制作系统。三个由不同团队使用不同打包格式构建的智能体,在单个 GPU 实例上的同一个会话中协作,并制作出了一首你可以播放的曲目。
该架构展示了若干可应用于音乐制作之外的模式:
- 通过共享会话实现共置。同一容量提供者上的多个智能体运行时在使用相同会话 ID 调用时会共享一个实例,从而为它们提供同一台主机:相同的 GPU、相同的本地卷、相同的进程空间。
- 独立团队部署。每个智能体都有自己的运行时生命周期。各团队无需协调即可按自己的节奏发布。
- 混合制品类型。容器和代码包在同一基础设施上共存。使用适合你团队工作流的任何打包方式。
- 多天持久化。工作暂停时停止会话,再次调用即可恢复。会话最长可持久保存 14 天(恢复取决于是否落在同一可用区)。
音乐只是一个方便的载体,但该架构本身与音乐毫无关系。替换掉渲染步骤,同样的三智能体形态就适用于 AWS 为 GPU Instances 列出的工作负载:3D 渲染、仿真、模型推理、媒体处理。或者适用于一个长时间运行的任务:由一条流水线生成大型制品,交给第二个智能体进行转换,再由第三个智能体在交付前检查结果。
要了解更多信息,请参阅 Amazon Bedrock AgentCore 文档。要获取本文完整的可运行代码,请浏览 AgentCore 示例仓库。要了解 Graph、Swarm 或 Workflow 等高级编排模式,请参阅 Strands Agents 文档。
关于作者

Evandro Franco
Evandro 是 Amazon Web Services 的一名高级数据科学家。他隶属于 Global GTM 团队,帮助 AWS 客户克服与 AWS 上 AI/ML 相关的业务挑战,主要涉及 Amazon Bedrock AgentCore 和 Strands Agents。他在技术领域拥有超过 18 年的经验,涵盖软件开发、基础设施、无服务器以及机器学习。闲暇时,Evandro 喜欢和他的儿子一起玩,主要是搭建一些有趣的乐高积木。

Rui Cardoso
Rui 是 AWS 的一名高级合作伙伴解决方案架构师,专攻代理式 AI 和物理 AI。他与 AWS 合作伙伴合作,将解决方案从原型推向生产,涵盖代理式工作负载和企业应用的准确性评估框架。他的重点是帮助合作伙伴在架构良好的基础上可靠地构建。

Sayee Kulkarni
Sayee 是 Amazon Bedrock AgentCore 服务的一名软件开发工程师。她的团队负责构建和维护 AgentCore Runtime 平台,这是一个基础组件,使客户能够利用代理式 AI 能力。她致力于交付切实的客户价值,这种以客户为中心的理念激励着她的工作。Sayee 主导了 AgentCore Runtime Instances 的设计和发布,推动该项目从架构设计到正式可用,使客户能够运行持久、长时间运行的代理式工作负载,并拥有构建复杂多智能体系统所需的灵活性和控制力。

Yanis Telaoumaten
Yanis 是 Amazon Bedrock AgentCore 服务的一名软件开发工程师。他的团队构建了 AgentCore Runtime Instances,这是一个让智能体能够在根据其特定需求定制的实例上运行数天的平台。Yanis 构思、设计并主导了该平台的实现,推动跨组织协作并扫清障碍,以确保成功交付。
来源:AWS Machine Learning Blog · aws.amazon.com